NaiveAI 27 вересня випустила відкриту модель Naive-N0.5-Flash для кодингу. У тесті Latent Space її медіанна відповідь найшвидша, але на складних питаннях вона генерує в середньому близько 108 500 токенів і програє DeepSeek за часом.
Що за модель Naive-N0.5-Flash?
Naive-N0.5-Flash від NaiveAI це відкрита MoE-модель, яку донавчили на основі Xiaomi MiMo-V2.5 і запускають на власному рушії NaiveRT. Вона має 309 млрд параметрів, 15,5 млрд активних на токен і контекст 1 млн токенів, за даними RuntimeWire. NaiveAI заявляє, що значну частину дослідницької й інженерної роботи виконували AI-системи.
Базова MiMo-V2.5, за даними Latent Space, має 310 млрд параметрів і 15 млрд активних, її навчали на 48T токенів. Для Naive її адаптували до шарів DeepSeek Sparse Attention, і за технічним блогом NaiveAI це забрало приблизно 3,25T додаткових токенів.
Наскільки Naive-N0.5-Flash швидша за конкурентів?
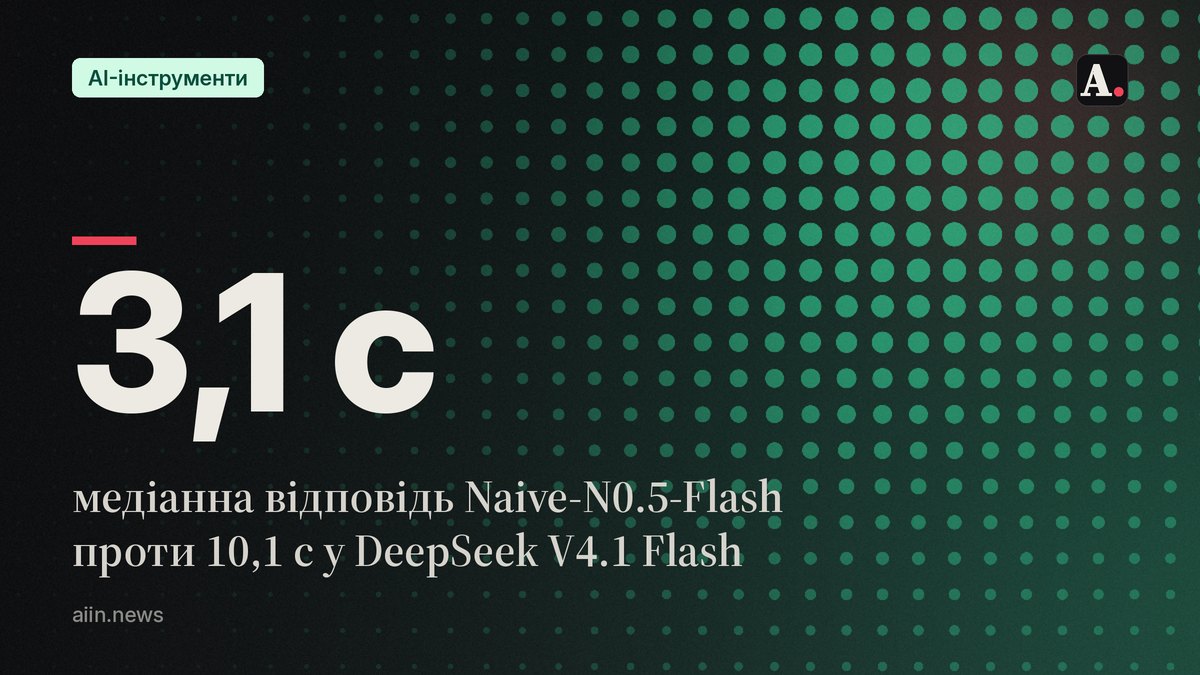
За медіанним часом відповіді Naive-N0.5-Flash з thinking швидша: 3,1 с проти 5,3 с у GLM 5.3 Flash (high) і 10,1 с у DeepSeek V4.1 Flash 1017 (high). Це швидше в 1,7 раза (5,3 / 3,1) і в 3,3 раза (10,1 / 3,1).
Середні значення вже майже збігаються з DeepSeek: 45,3 с у Naive проти 45,0 с. GLM у середньому потребує 86,9 с. На складних питаннях HLE-Diamond Naive з thinking у середньому повільніша за DeepSeek: 89,8 с проти 79,7 с.
Чому середнє так відрізняється від медіани?
Середнє Naive-N0.5-Flash тягне вгору кілька надзвичайно довгих ланцюжків міркування. На складних питаннях HLE модель з thinking генерувала в середньому близько 108 500 токенів, це приблизно в 9 разів більше за GLM 5.3 Flash (high) і в 11 разів більше за DeepSeek V4.1 Flash 1017 (high).
Медіана по всіх 30 питаннях лише близько 3 200 токенів, а середнє перевищує 51 000. Схожий патерн є й в інших моделей, але слабший. Автори також пишуть, що одне питання обходиться трохи дорожче, але цифр вартості не наводять.
Чому ці цифри не можна читати як вирок?
Вибірка Latent Space мала: по 10 питань на кожен із трьох рівнів складності (MATH-500, GPQA-Diamond, HLE-Diamond), разом 30 на модель. Правильність відповідей автори не оцінювали, тож швидкість ще не означає якість.
Джерела швидкості теж різні: для DeepSeek і GLM дані з OpenRouter, для Naive це серверні вимірювання. Тому Latent Space не називає точного множника швидкості. Intelligence Index на Artificial Analysis для Naive ще недоступний, а в DeepSeek V4.1 Flash 1017 (Max) він становить 45, у GLM-5.3-Flash 43. За опублікованими результатами кодування Naive лежить між двома моделями й випереджає обидві на NL2Repo-Bench.