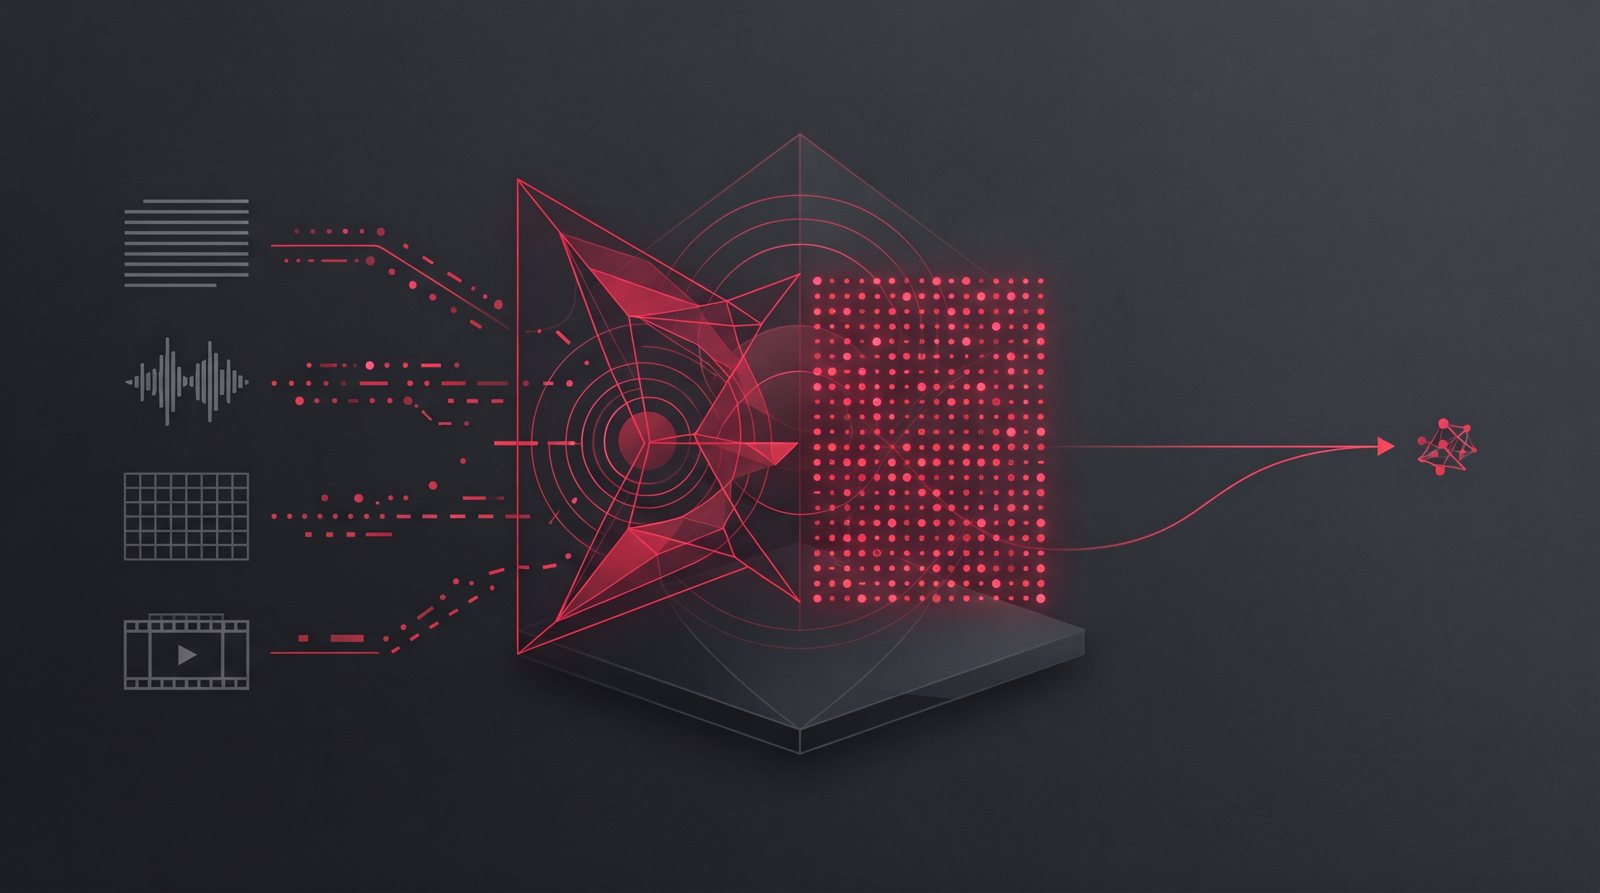
EmbeddingGemma 2 від Google DeepMind перетворює текст, код, зображення, відео й аудіо на один вектор на 768 вимірів і має 740M параметрів під ліцензією Apache 2.0.
Це спосіб прибрати платний embedding-API з критичного шляху пошуку. Вектори, побудовані на пристрої, лишають дані локально, скорочують затримку і працюють без мережі. Ваги вже доступні на Hugging Face і Kaggle, є збірки під Ollama, llama.cpp GGUF і LiteRT. За даними MarkTechPost, модель цілиться в пошук на пристрої, класифікацію та приватний RAG.
Як один вектор шукає текст, фото і звук?
EmbeddingGemma 2 побудована на архітектурі Gemma 4 і вписує всі модальності в єдиний простір на 768 вимірів. Текстовий запит знаходить фото, а голосова нотатка — відеофрагмент. Змішаний вхід на кшталт картки товару з текстом, картинками і демороликом дає один ембединг.
Модель складається з трьох частин: текстове й кодове ядро на 270M параметрів, зір на 170M та аудіоенкодер на 300M. Розробник вантажить лише потрібне: 270M для тексту, 440M для тексту із зором, 570M для тексту з аудіо або 740M для всього. Усі конфігурації живуть в одному просторі, тож запит, закодований текстовою збіркою, знаходить документи, закодовані повною моделлю. Усередині ядра 130M параметрів припадає на трансформер, 140M — на ембединг-шар.
Скільки пам’яті треба на телефоні?
З квантуванням на Pixel 11 Pro активна RAM для текстової збірки EmbeddingGemma 2 становить близько 191MB, а для повної мультимодальної — близько 567MB. Квантування зі врахуванням навчання стискає ваги до INT4 та INT8. Команда Google AI Edge виміряла 37,3 мс на зображення на MacBook M5 Pro GPU при бюджеті зору в 70 токенів.
Контекстне вікно сягає 8 192 токенів, учетверо більше за першу версію. Туди вміщається близько 29 зображень, 58 відеокадрів або 5,5 хвилини аудіо. Matryoshka Representation Learning (MRL) дозволяє скорочувати вектор до 512, 256 або 128 вимірів, і сховище від того меншає до 6 разів. На 256 вимірах багатомовний MTEB просідає лише з 61,36 до 60,41, а на 128 вимірах MMEB падає до 45,65, тому Google радить 128 вимірів переважно для текстових задач.
Де модель виграє, а де програє конкурентам?
За повідомленням дослідницької команди Google, EmbeddingGemma 2 веде серед мультимодальних ембедерів до 1B параметрів на MTEB Code і MAEB у повній точності на 768 вимірах. Пошук коду зростає з 68,76 до 78,68 — на 9,92 пункта або приблизно 14%. Багатомовна якість тексту тримається на рівні попередньої версії.
Більші моделі досі попереду на окремих дошках: Qwen3-VL-Embedding-2B показує 73,2 у власному прогоні MMEB-V2, має приблизно у 2,7 раза більше параметрів і не підтримує аудіо.
Що робити зараз
Командам варто прогнати EmbeddingGemma 2 на власному корпусі та порахувати витрати на інфраструктуру.
- Завантажуйте ваги через ollama pull embeddinggemma-2: текстова збірка 270m займає 378MB, повна 740m — 1,3GB.
- Лишайте 768 вимірів для мультимодального пошуку, переходьте на 256, якщо сховище тисне, а 128 вимірів залишайте для тексту.
- Збирайте стек на sentence-transformers від версії 6.1.0, Transformers, vLLM, SGLang, MLX, llama.cpp, LM Studio, LiteRT і MediaPipe, вектори кладіть у Qdrant, тонке налаштування робіть через Unsloth.
- Перевірте демо в Google AI Edge Gallery і закладіть підтримку ML Kit на Android із прискоренням NPU, яка з’явиться за кілька тижнів. Комерційне використання дозволяє ліцензія Apache 2.0.